Agents IA : analyser les incidents broadcast
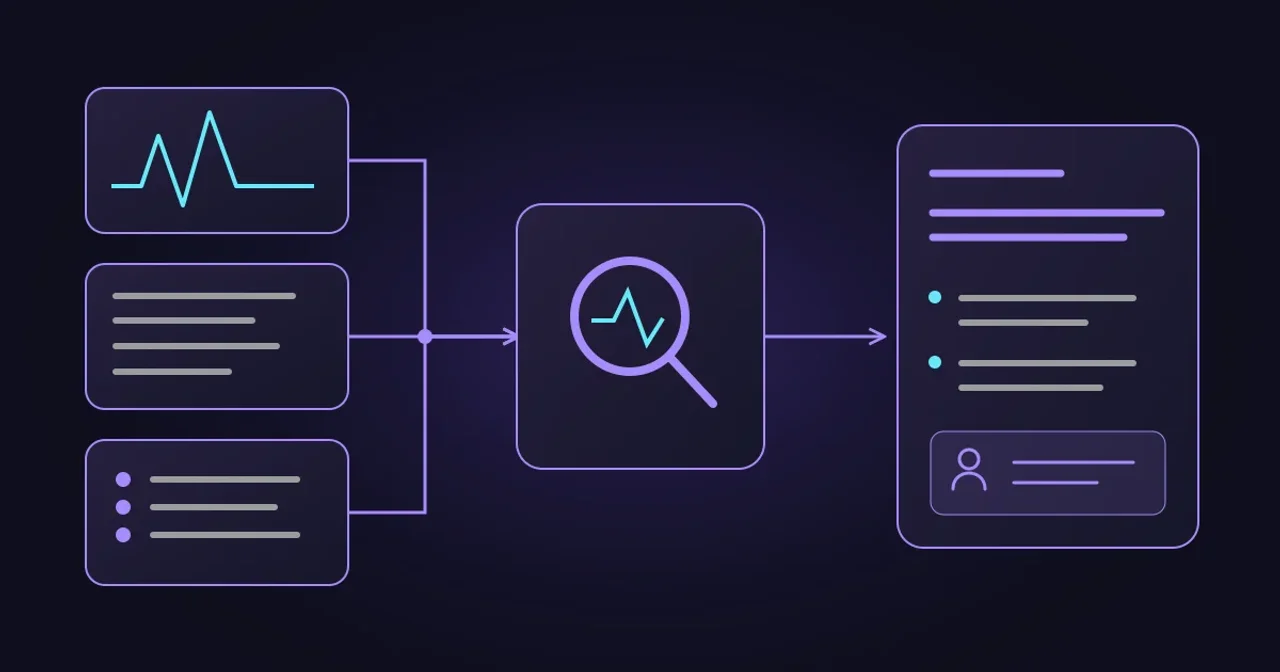
Les agents d’IA dédiés aux enquêtes sur les incidents de diffusion pourraient apporter une solution à un problème récurrent dans les salles de contrôle : l’alerte est claire, mais les informations nécessaires à son interprétation sont dispersées entre plusieurs systèmes. La sortie d’une chaîne semble fonctionner normalement, alors que les téléspectateurs d’un chemin de distribution signalent un blocage de la lecture. Quelqu’un doit alors déterminer l’étendue du problème, comparer les données et décider de la prochaine étape de vérification.
Notre présentation de l’IA agentique dans les opérations de diffusion expose les cas où une enquête adaptative peut s’avérer utile. Nous examinons ici les éléments dont un opérateur a besoin avant d’autoriser une action de rétablissement. Le workflow ci-dessous est une proposition d’architecture, et non une description de fonctionnalités d’agents IA déjà déployées chez Evrideo.
Fournissez aux agents IA chargés des enquêtes sur les incidents de diffusion des éléments probants exploitables
Conservez les alarmes fiables et de procédures de rétablissement bien établies. Les recommandations SRE de Google distinguent les symptômes observés en externe des signaux de diagnostic internes et mettent en garde contre l’idée que la surveillance puisse établir automatiquement un lien de causalité. Un agent doit respecter ces principes. Google SRE : Surveillance des systèmes distribués.
Un script peut regrouper des enregistrements et exécuter un guide d’intervention à embranchements. Un agent peut s’avérer utile lorsque la prochaine étape de l’enquête dépend d’une combinaison inhabituelle de résultats : sélectionner un autre outil de diagnostic, interpréter une note opérationnelle ou réviser une explication lorsqu’une comparaison la contredit. Cette flexibilité doit être testée par rapport au processus existant.
Reliez les identifiants et les horodatages
Attribuez à l’investigation une chaîne, une variante d’encodage, une destination et une fenêtre d’observation. Mettez en correspondance les identifiants utilisés par le playout, le packaging, la distribution et les rapports du lecteur. OpenTelemetry prend en charge la corrélation à travers le temps, le contexte d’exécution et le contexte des ressources ; il ne crée pas automatiquement la carte de votre service de diffusion. Certains journaux d’infrastructure ne disposent pas de contexte de trace. Spécification de journalisation OpenTelemetry.
Enregistrez séparément l’heure de l’événement et l’heure de collecte. Le format UTC ne prouve pas que les horloges sont synchronisées. Gardez visible l’incertitude connue relative à l’horloge et utilisez, lorsque cela est possible, le temps écoulé mesuré par une sonde fiable pour les mesures répétées. Sinon, une séquence apparente de défaillances peut simplement refléter un retard dans la télémétrie.
Incluez les symptômes signalés par l’utilisateur
Les requêtes réussies à la source ne vous renseignent guère sur la progression d’un lecteur particulier. Common Media Client Data (CMCD) définissent des informations structurées sur le lecteur, notamment la durée de média en mémoire tampon et les signaux d’épuisement du tampon, qui peuvent accompagner les requêtes de diffusion ou parvenir aux points de terminaison de collecte. Les champs disponibles dépendent de l’implémentation et des informations dont dispose le lecteur. CTA WAVE : Common Media Client Data.
Utilisez les données du lecteur en complément des sondes de diffusion. Enregistrez le groupe d’appareils concernés, le territoire et la couverture du rapport, le cas échéant. Les données manquantes concernant le lecteur doivent rester explicitement signalées comme telles.
Analysez une liste de lecture en direct obsolète
Prenons l’exemple hypothétique d’une chaîne HLS classique. Une alerte déterministe signale une playlist multimédia potentiellement obsolète sur un site du CDN. Les autres sites semblent fonctionner correctement. L’agent dispose d’un accès en lecture seule aux outils de diagnostic approuvés et aux enregistrements opérationnels expurgés.
Comparez le même chemin de diffusion
Recueillez des instantanés répétés de la même liste de lecture logique à l’origine, au site affecté A et au site de comparaison B. Vérifiez la variante d’encodage, le site de diffusion et toute personnalisation susceptible de sélectionner un contenu différent. Enregistrez les temps de récupération, le contenu des listes de lecture et indiquez si les segments nouvellement répertoriés peuvent être récupérés.
Inspectez le dernier segment disponible, et pas seulement EXT-X-MEDIA-SEQUENCE. Cette balise identifie le premier segment répertorié ; une liste de lecture en mode « ajout uniquement » peut donc progresser sans la modifier. Des numéros de séquence identiques dans différentes listes de lecture ne garantissent pas que le contenu corresponde. Utilisez la chronologie et les durées de segments correspondantes pour évaluer le décalage. RFC 8216 : HTTP Live Streaming.
Effectuez un échantillonnage sur une période adaptée à la cadence de publication du flux. Une seule réponse inchangée constitue une preuve insuffisante. Si l’origine et le serveur B continuent d’avancer tandis que le serveur A renvoie de manière répétée un contenu plus ancien, l’investigation peut se concentrer sur le chemin de diffusion du serveur A.
Essayez de réfuter la première explication
L’agent doit demander des preuves permettant de distinguer les causes possibles. Vérifiez si A atteint l’origine attendue, si un cache intermédiaire présente des différences et si une autre sonde autorisée reproduit le symptôme. Passez en revue les modifications de configuration pertinentes sans considérer leur proximité dans le temps comme une preuve de causalité.
Si l’origine cesse également d’avancer, examinez le packaging ou les dépendances en amont partagées. Si la playlist avance mais que les segments échouent, inspectez la diffusion des segments. Si la deuxième sonde fonctionne, examinez le routage, les différences entre les requêtes et la mesure d’origine avant de recommander une modification du cache.
C’est là qu’un agent pourrait faire ses preuves : en choisissant la prochaine question pertinente et en actualisant son explication à partir de preuves incomplètes. Les vérifications connues et les calculs de synchronisation doivent rester des outils déterministes. Une enquête non résolue doit se conclure par l’identification d’une lacune évidente dans les preuves et la désignation d’un responsable de l’escalade.
Fournissez à l’opérateur une décision qu’il peut examiner
Préparez un rapport d’incident concis avec des liens vers les observations sources :
- Portée : chaîne, variante d’encodage, emplacement de diffusion confirmé, fenêtre d’observation et groupe de lecteurs concernés.
- Preuves : comparaison origine/A/B, résultats de la récupération des segments, symptômes observés chez les lecteurs et incertitude liée à l’horloge.
- Évaluation : explication principale, alternative la plus plausible, constatations contradictoires et enregistrements manquants.
- Action proposée : étape précise du guide d'intervention ou prochain contrôle de diagnostic, effet attendu, opérateur responsable et conditions de retour en arrière.
- Test de rétablissement : ce qui doit être amélioré, où cela sera mesuré et pendant combien de temps l’observation doit se poursuivre.
Évitez d’utiliser un score de confiance exprimé en pourcentage, sauf s’il a été calibré par rapport à des incidents représentatifs. Les opérateurs doivent comprendre pourquoi la recommandation découle des preuves. Supprimez les jetons d’accès et les identifiants personnels des données transmises au modèle.
Les purges de cache, les modifications de routage et les redémarrages de services nécessitent des autorisations et des validations appliquées séparément. Traitez les journaux, les commentaires des listes de lecture et les documents récupérés comme des preuves non fiables : une instruction qui y est intégrée ne doit jamais accorder d’autorité. L’OWASP recommande de limiter les fonctionnalités et les privilèges des agents, d’appliquer l’autorisation en aval et d’exiger une validation pour les actions ayant des conséquences importantes. OWASP : Excessive Agency.
Prouvez que l’investigation est utile
Après une intervention approuvée, répétez les mêmes comparaisons. Recherchez une progression soutenue de la liste de lecture, de nouveaux segments récupérables et la disparition des symptômes observés au niveau du lecteur. Vérifiez l’absence de régressions à l’emplacement non affecté. Lorsque seules des sondes sont disponibles, signalez le rétablissement observé par les sondes plutôt que d’affirmer que tous les utilisateurs ont retrouvé l’accès.
Avant la mise en production, rejouez des incidents historiques en y introduisant des modifications trompeuses, des journaux différés et des défaillances multiples. Comparez les rapports de l’agent avec les outils et les guides d’intervention existants de l’équipe. Évaluez la précision des preuves, les conclusions non étayées, les corrections apportées par les opérateurs, le coût des requêtes et la remontée appropriée lorsque les preuves sont insuffisantes.
Consignez séparément l’heure de l’alerte, celle où les preuves sont disponibles, celle de l’approbation et celle du rétablissement durable. Un rapport plus rapide n’est utile que s’il permet de prendre une décision éclairée ; il ne garantit pas une réduction du temps total de reprise.
Choisissez une catégorie d’incidents récurrents pour un premier projet pilote d’agents IA destinés à l’investigation des incidents de diffusion. La plateforme Broadcast d’Evrideo fournit la base opérationnelle des chaînes ; toute intégration d’agent proposée nécessite ses propres contrôles d’accès et tests d’acceptation. Discutez avec Evrideo des investigations qui mobilisent le temps de votre équipe et des éléments de preuve nécessaires pour évaluer un projet pilote.
Articles associés
Agents IA : de l'ingestion à la mise à l'antenne
23 septembre 2026 · 7 min de lecture
Programmation TV et FAST par IA : quelles métadonnées ?
23 septembre 2026 · 7 min de lecture
IA agentique en opérations broadcast : par où commencer ?
10 septembre 2026 · 6 min de lecture