Agentes de IA para investigar incidentes broadcast
Los agentes de IA para la investigación de incidencias en la radiodifusión podrían ayudar a resolver un problema habitual en las salas de control: la alarma es clara, pero la explicación se encuentra dispersa en varios sistemas. La señal de salida de un canal parece funcionar correctamente, mientras que los espectadores de una vía de distribución informan de que la reproducción se ha bloqueado. Alguien debe determinar el alcance del problema, comparar las pruebas y decidir cuál es el siguiente paso a seguir.
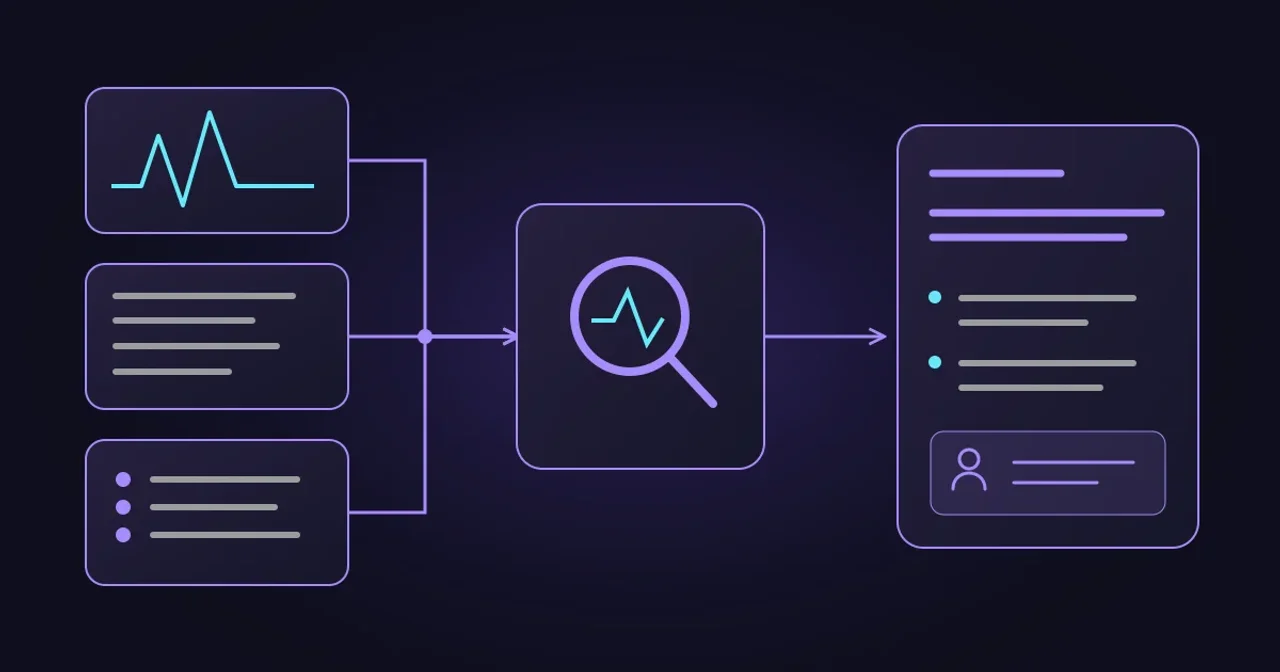
Nuestra introducción a la IA agéntica en las operaciones de radiodifusión establece en qué casos puede resultar útil la investigación adaptativa. Aquí examinamos las pruebas que necesita un operador antes de autorizar una acción de recuperación. El flujo de trabajo que se muestra a continuación es una arquitectura propuesta, no una descripción de funciones de agentes de IA ya implementadas en Evrideo.
Proporciona a los agentes de IA para la investigación de incidencias de radiodifusión pruebas útiles
Mantén alarmas fiables y procedimientos de recuperación establecidos. La guía de SRE de Google distingue entre los síntomas observados externamente y las señales de diagnóstico internas, y advierte de que no se debe dar por sentado que la monitorización puede establecer la causalidad de forma automática. Un agente debe trabajar dentro de esa disciplina. Google SRE: Monitorización de sistemas distribuidos.
Un script puede unir registros y ejecutar un manual de procedimientos con ramificaciones. Un agente puede resultar útil cuando la siguiente indagación dependa de una combinación desconocida de resultados: seleccionar otra herramienta de diagnóstico, interpretar una nota operativa o revisar una explicación cuando una comparación la contradiga. Esa flexibilidad debe someterse a pruebas comparativas con el proceso existente.
Relaciona identificadores y marcas de tiempo
Asigna a la investigación un canal, una representación, un destino y una ventana de observación. Relaciona los identificadores utilizados por el playout, el empaquetado, la distribución y los informes del reproductor. OpenTelemetry admite la correlación a lo largo del tiempo, el contexto de ejecución y el contexto de los recursos; no crea automáticamente el mapa de tu servicio de difusión. Algunos registros de infraestructura carecen de contexto de rastreo. Especificación de registro de OpenTelemetry.
Registra por separado la hora del evento y la hora de recopilación. El formato UTC no garantiza que los relojes estén sincronizados. Mantén visible la incertidumbre conocida del reloj y, cuando sea posible, utiliza el tiempo transcurrido de una sonda fiable para las mediciones repetidas. De lo contrario, una secuencia aparente de fallos puede deberse simplemente a un retraso en la telemetría.
Incluye los síntomas del espectador
Las solicitudes exitosas en el origen aportan poca información sobre si un reproductor concreto está avanzando. Common Media Client Data (CMCD) definen información estructurada del reproductor, incluida la duración de contenido en el búfer y las señales de agotamiento del búfer, que puede acompañar a las solicitudes de entrega o llegar a los puntos finales de recogida. Los campos disponibles dependen de la implementación y de la información de que disponga el reproductor. CTA WAVE: Common Media Client Data.
Utiliza los datos del reproductor junto con las pruebas de entrega. Registra el grupo de dispositivos afectados, el territorio y la cobertura de los informes, cuando estén disponibles. Los datos del reproductor que falten deben quedar marcados explícitamente como lagunas.
Investiga una lista de reproducción en directo obsoleta
Consideremos un canal HLS convencional hipotético. Una alarma determinista informa de una lista de reproducción multimedia posiblemente obsoleta en una ubicación de la CDN. El resto de ubicaciones parecen estar en buen estado. El agente tiene acceso de solo lectura a herramientas de diagnóstico autorizadas y a registros operativos sin datos sensibles.
Compara la misma ruta de distribución
Recopila instantáneas repetidas de la misma lista de reproducción lógica en el origen, la ubicación afectada A y la ubicación de comparación B. Confirma la representación, la ubicación de servicio y cualquier personalización que pudiera seleccionar contenido diferente. Registra los tiempos de recuperación, el contenido de la lista de reproducción y si se pueden recuperar los segmentos recién añadidos.
Inspecciona el último segmento disponible, no solo EXT-X-MEDIA-SEQUENCE. Esa etiqueta identifica el primer segmento de la lista, por lo que una lista de reproducción de solo adición puede avanzar sin cambiarla. Los números de secuencia iguales en diferentes listas de reproducción no garantizan que el contenido coincida. Utiliza la línea temporal y las duraciones de los segmentos coincidentes al evaluar el retraso. RFC 8216: HTTP Live Streaming.
Realiza un muestreo durante un periodo adecuado a la cadencia de publicación de la transmisión. Una sola respuesta sin cambios es una prueba poco concluyente. Si el origen y el punto B siguen avanzando mientras que el punto A devuelve repetidamente contenido antiguo, la investigación puede centrarse en la ruta de entrega del punto A.
Intenta refutar la primera explicación
El agente debe solicitar pruebas que distingan las posibles causas. Comprueba si A llega al origen esperado, si una caché intermedia difiere y si otra sonda autorizada reproduce el síntoma. Revisa los cambios de configuración relevantes sin considerar su momento de aparición como prueba de causalidad.
Si el origen también deja de avanzar, investiga el empaquetado o las dependencias compartidas en la fase anterior. Si la lista de reproducción avanza pero los segmentos fallan, inspecciona la entrega de segmentos. Si la segunda sonda funciona, examina el enrutamiento, las diferencias en las solicitudes y la medición original antes de recomendar un cambio en la caché.
Aquí es donde un agente podría demostrar su valía: eligiendo la siguiente pregunta útil y actualizando su explicación a partir de pruebas incompletas. Las comprobaciones conocidas y los cálculos de tiempo deben seguir siendo herramientas deterministas. Una investigación sin resolver debe concluir con una laguna de pruebas clara y un responsable de la escalación.
Proporciona al operador una decisión que pueda revisar
Elabora un informe de incidente conciso con enlaces a las observaciones de origen:
- Ámbito: canal, representación, ubicación de entrega confirmada, ventana de observación y grupo de usuarios afectados.
- Pruebas: comparación de origen/A/B, resultados de la recuperación de segmentos, síntomas de los reproductores e incertidumbre en la sincronización.
- Evaluación: explicación principal, alternativa más sólida, hallazgos contradictorios y registros que faltan.
- Medida propuesta: paso exacto del manual de procedimientos o siguiente comprobación de diagnóstico, efecto esperado, operador responsable y condiciones de reversión.
- Prueba de recuperación: qué debe mejorar, dónde se medirá y cuánto tiempo debe continuar la observación.
Evita utilizar una puntuación de confianza porcentual a menos que se haya calibrado con incidentes representativos. Los operadores deben comprender por qué la recomendación se deriva de las pruebas. Elimina los tokens de acceso y los identificadores personales del material que se envía al modelo.
Las purgas de caché, los cambios de enrutamiento y los reinicios de servicio requieren permisos y aprobaciones que se apliquen por separado. Trata los registros, los comentarios de las listas de reproducción y los documentos recuperados como pruebas no fiables: una instrucción incrustada en ellos nunca debe otorgar autoridad. OWASP recomienda limitar la funcionalidad y los privilegios de los agentes, aplicar la autorización en las etapas posteriores y exigir aprobación para las acciones con consecuencias importantes. OWASP: Agencia excesiva.
Demuestra que la investigación es útil
Tras una intervención aprobada, repite las mismas comparaciones. Busca una progresión sostenida de la lista de reproducción, nuevos segmentos recuperables y la desaparición de los síntomas observados en el reproductor. Comprueba si hay regresiones en la ubicación no afectada. Cuando solo se disponga de sondas, informa de la recuperación observada por las sondas en lugar de afirmar que todos los espectadores se han recuperado.
Antes de su uso en producción, reproduce incidentes históricos con cambios engañosos, registros retrasados y fallos múltiples. Compara los informes del agente con las herramientas y los manuales operativos existentes del equipo. Mide la precisión de las pruebas, las conclusiones sin fundamento, las correcciones de los operadores, el coste de las consultas y la escalación adecuada cuando las pruebas sean insuficientes.
Registra por separado la hora de la alerta, la disponibilidad de las pruebas, la aprobación y la recuperación sostenida. Un informe más rápido solo es útil si respalda una decisión acertada; no implica una reducción del tiempo total de recuperación.
Elige una clase de incidente recurrente para una prueba piloto inicial de agentes de IA destinados a la investigación de incidentes de radiodifusión. La plataforma Broadcast de Evrideo proporciona la base para las operaciones del canal; cualquier integración de agentes propuesta requiere sus propios controles de acceso y pruebas de aceptación. Habla con Evrideo sobre las investigaciones que consumen el tiempo de tu equipo y las pruebas necesarias para evaluar una prueba piloto.
Artículos relacionados
Agentes de IA: de la ingesta a la emisión
23 de septiembre de 2026 · 7 minutos de lectura
Programación TV y FAST con IA: metadatos esenciales
23 de septiembre de 2026 · 7 minutos de lectura
IA agéntica en operaciones broadcast: ¿por dónde empezar?
10 de septiembre de 2026 · 6 minutos de lectura